

|
盖世具身智能获悉 近日,星尘智能团队发布了在线强化学习框架SmoothRL,由王佳楠担任项目负责人。该框架首次将异步online RL放到真实高动态投掷任务中验证,让在线学习不只处理“最后几毫米”的精度问题,也进入连续加速、精确释放、不能停顿的动态操作,从而解决机器人在连续执行任务过程中,模型异步推理与真实执行动作不一致导致的在线学习复盘偏差问题。 为此,SmoothRL把一段动作分成三部分:前面已经被上一轮动作占用的是Committed Region,中间真正落到机器人身上的是Execution Region,后面还没执行就被新计划替换的是Discarded Region。策略更新只针对真正执行的中间这一段。 团队把这个原则叫做Reinforce in Deployment:机器人真实工作是什么节奏,强化学习就按什么节奏学。 星尘智能团队在Astribot S1机器人上测试了动态投掷、给笔戴帽和开箱三项任务: 动态投掷:39%94%。机器人要把不同位置的物体投进不同位置的目标箱。除了判断方向,还要根据远近调整释放速度,而且整个摆臂过程不能突然停下来。在累计250个rollout episodes的评估节点,成功率从39%提升到94%。 给笔戴帽:8%83%。双臂需要把笔和笔帽准确对齐,允许的相对位姿误差小于5mm。基础策略往往已经到了目标附近,最后几毫米却经常对不上。 开箱:30%90%。机器人要把约1mm宽的刀片插进只有2-3mm宽的箱盖接缝。基础策略存在稳定的左偏,经常直接扎进纸板;在线学习后,最终成功率达到 90%。 在线强化学习后,机器人失败模式发生显著变化。开箱任务的失败样本中,刀片相对接缝的左右偏差缩小到1—2mm;给笔戴帽的失败样本也主要变成正确位置附近的小幅错位。在真实自主投掷rollout中,在线RL后右侧末端执行器的加速度RMS降低52%,jerk降低47% 不过星尘智能表示,SmoothRL当前还存在一定边界,模型推理时间需要控制在预设预算内,而且当前方法主要是在冻结基础策略附近做有限幅度的修正。如果基础策略本身离正确动作太远,轻量RL模块也很难凭空救回来。 但至少在这三个任务里,可以看到一个很直观的范式:基础模型先让机器人学会怎么做,真实世界里的后训练,再把最后几毫米一点点练准。 郑重声明:此文内容为本网站转载企业宣传资讯,目的在于传播更多信息,与本站立场无关。仅供读者参考,并请自行核实相关内容。 |
十年前,想要买一台家轿,身边的朋友毫无例外都会推荐合资品牌。而最近,当我和亲朋好友们谈论买车话题时,...
年轻人买车不只是为了方便日常通勤,也为了能随时随地去郊外“撒撒野”来场说走就走的旅行。在过去,能够满...
自北京冬奥会开幕以来,吉祥物冰墩墩逐渐成为新晋顶流网红,有的商场把它当成吸睛神器,有的家庭把它作为温...
双十一临近,各种福利攻略铺面而来。奇瑞诚意满满,新世代潮跑SUV欧萌达“神助攻”,送上双十一限时五重...
当下10多万级的紧凑型SUV市场,自主品牌还是占据了绝大部分的话语权。不过,随着合资品牌新车型的不断...
估计任何一个花粉都没有想到被余承东疯狂吹捧的问界M7安全性如此之差吧,不知道多少理性的消费者感到庆幸...

随着空气慢慢暖和起来,无论是在家里还是在车上,通风都是一件需要落实的事情了。尤其是春季有利于病毒传染,如...查看全文
掐指一算,立冬已过,winter is coming!每年都是还没做好入冬的准备,人...查看全文
2022G20峰会将在印度尼西亚巴厘岛召开,作为G20峰会官方用车,300台五菱首款新能源全球车Aire...查看全文
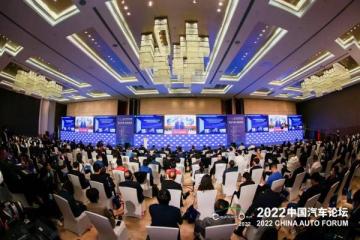
11月8日至10日,由中国汽车工业协会主办的2022中国汽车论坛在上海举行。论坛期间正式发布了“2022...查看全文
本周具身智能领域大事如下: 宇树股价、市值双双腰斩 9月2日,A股“人形机器人第一股”宇树科技在...查看全文